
定應用積體電路(Application Specific Integrated Circuit,ASIC)已是行之有年的統包設計(Turnkey Design)方案。如今隨著人工智慧(AI)應用的普及,與其他超大型積體電路(Very Large Scale Integration,VLSI)技術相比,ASIC的優勢似乎更加明顯。
ASIC優缺點分析
CPU的通用型指令集(Instruction Set)可以支援各種應用所需的運算,但電路設計的複雜度高且耗電;與之相對,ASIC的指令集被限制只支援特定的運算,因此十分適合深度學習使用,能針對特定指令集執行大量的分散式平行運算,較不耗電。
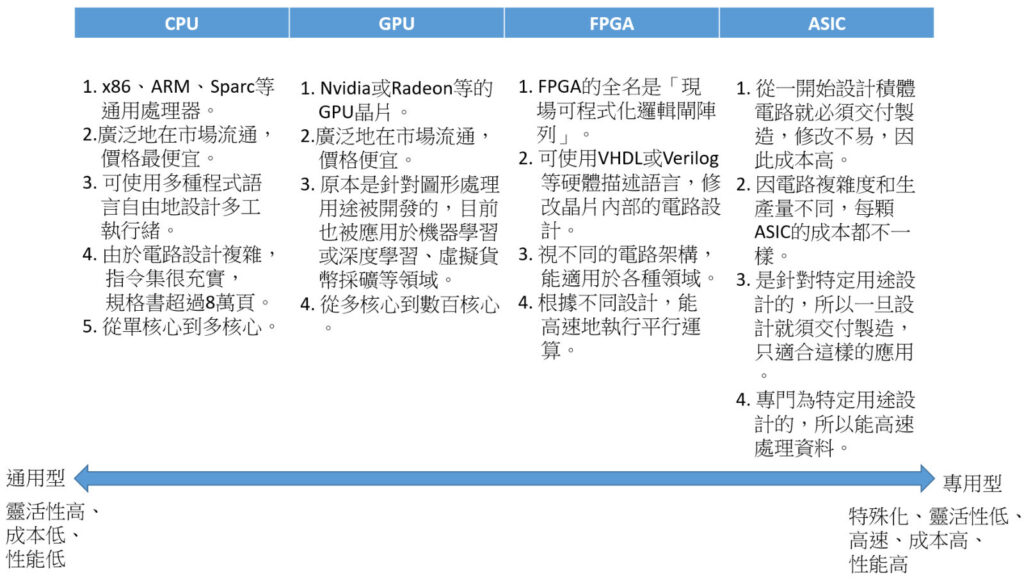
圖1按照晶片的應用屬性(通用型或專用型)來區分CPU、GPU、FPGA、ASIC。與其他類型的晶片相比較,ASIC具有下列優勢:
・為特定應用量身定做:只針對特定應用提供最佳化功能,對AI應用而言,能對類神經網路(Artificial Neural Network, ANN)進行微調,例如大型矩陣(Matrix)的乘法運算、卷積(Convolutipn)作業。在這些方面,ASIC比通用型處理器更有效率。
・省電:對於需要大量運算力的AI應用而言,省電是非常重要的事。電源管理和散熱對資料中心(Data Center)和邊緣裝置(Edge Device)尤其重要。
・高速處理:由於可以將ASIC設計成直接在硬體上執行特定的AI演算法,省去了必須透過中間層處理的過程,與通用型處理器(如CPU和GPU)相比,ASIC的處理速度更快、延遲時間更短。
・布建成本不高:ASIC設計完成後,可以用較低的成本生產,在這方面,其他VLSI無法與其相比。因此,ASIC適合大型AI應用的布建或部署,雖然初期投入的設計成本通常比較高。
・易與其他系統整合:由於ASIC體積小,很容易和行動式、嵌入式裝置整合在一起。因此,ASIC適合應用於空間較狹小的自駕車、無人機、物聯網(IoT)裝置上。
・通訊保密:ASIC是特製的積體電路,因此能視需求結合不同的特殊編碼技術、安全的開機機制,來保護AI的應用資料。
・擴展性高:ASIC可以支援高功率、高效能的資料運算,例如雲端資料中心。同時,ASIC也能支援低功率、較小型的邊緣裝置的運算。
不過,ASIC也具有下列缺點:
・初期投入的研發成本高:這包含設計用工具、工程資源、導入製造等費用。
・開發時程長:從設計、測試到生產,所花費的時間較長,可能會影響產品上市的預定時間。
・設計的靈活性低:ASIC一旦交付生產,電路就固定了,無法使用程式重新設計或修改設計。在靈活設計方面,ASIC無法和FPGA相比。因此,ASIC無法支援需要經常修改或更新設計的應用領域。
・高風險:若設計有誤,修正和重新製造所需的成本和時間可能十分可觀。
・仰賴規模經濟:ASIC只有在大量生產時,才具有成本效益。對於較少的生產量,高昂的一次性工程(Non-recurring Engineering, NRE)費用可能使成本過高。
・設計的複雜度高:設計ASIC需要專業知識和技能,使其開發流程更加複雜且具有挑戰性。
目前,業界已有張量處理單元(Tensor Processing Unit, TPU)、深度學習加速器(Deep Learning Accelerator,DLA)上市,這兩者都屬於ASIC,是為了加速機器學習或針對特定應用而設計。TPU分為兩種,一種是供雲端伺服器使用的TPU,專門出租給客戶使用,讓客戶不需要另外購買硬體設備,即能充分利用TPU的機器學習能力;另一種是供邊緣裝置使用的TPU,以模組化設計,藉助應用開發工具即可將TPU模組整合至客戶自己設計的硬體裝置內。DLA同樣分為兩種,一種是在通用型或半通用型處理器中即內建DLA核心,如此可加快機器學習的速度;另一種是將DLA核心整合至客戶自己設計的ASIC或系統單晶片(SoC)中,但這種整合技術需要事先獲得授權。
電子設計自動化
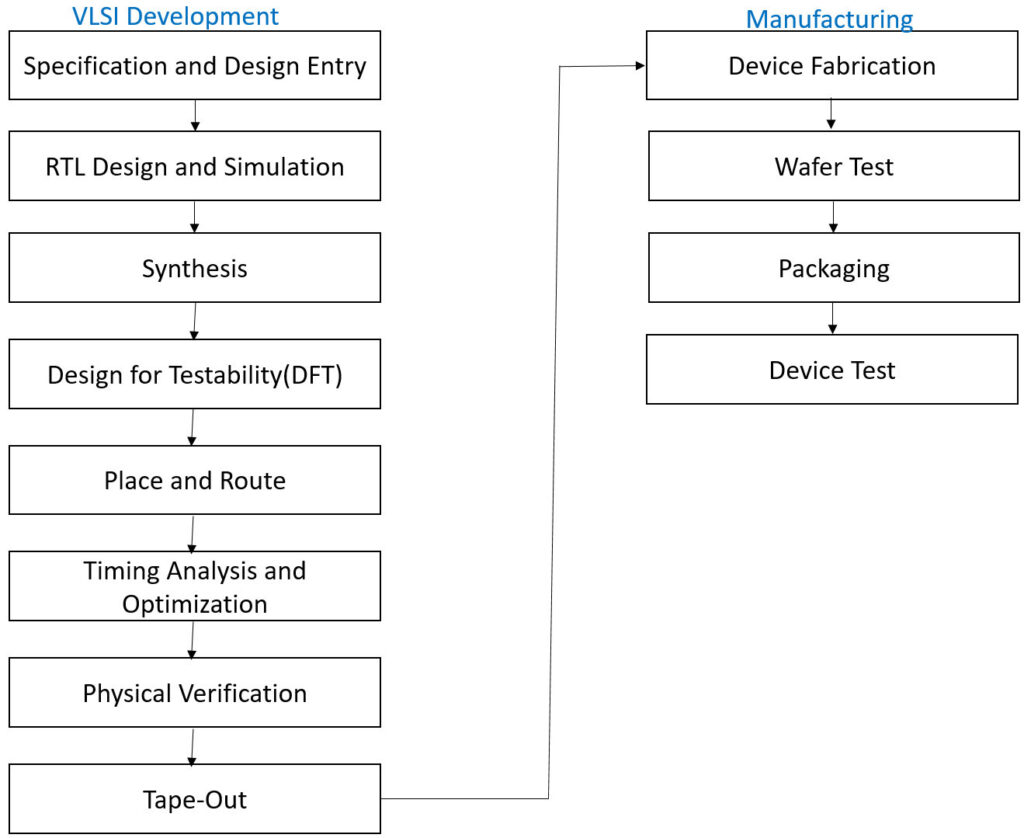
晶片從設計到交付製造(或稱之投片(Tape-out))都需要電子設計自動化(EDA)軟體。因此,在討論ASIC的開發流程之前,須了解EDA的開發流程。使用EDA工具開發晶片是非常繁複的過程,大致上,EDA的開發流程可區分為下列八個循環設計階段:
・規格和設計描述(Design Entry):定義功能和限制條件,接著使用硬體描述語言(HDL)設計和描述電路,例如VHDL或Verilog。
・暫存器傳輸級(RTL)設計和模擬(Simulation):設計高階的暫存器電路,並透過模擬驗證功能。
・合成(Synthesis):將RTL設計轉成閘級(Gate-level)的網表(Netlist)。
・可測性設計(DFT):將具有測試功能的特殊結構和電路結合,例如掃描鏈(Scan Chain)和內建自我測試(BIST)機制,以便製造後進行測試。
・布線(Place)與繞線(Route):決定邏輯閘(Logic Gate)的最佳位置,並將它們連接起來。
・時序分析(Timing Analysis)和最佳化:確保設計的電路符合時序規格的要求,並進行最佳化。
・實體驗證(Physical Verification):檢查是否違反設計規則,並確保布局(Layout)與電路圖(Schematic)相符。
・交付矽晶圓廠製造:設計完成,產出製造用資料。
通常,EDA的開發流程遵循從第一階段到第八階段的順序,例如在進行布線與繞線之前,必須先合成網表。不過,依規格需求和使用的EDA工具的不同,能夠彈性調整這個順序,例如在進行合成階段之前,需要重覆執行RTL設計和模擬,不斷對所設計的電路進行微調;又例如在布線與繞線階段,若發現時序或布局問題,可能需要回到合成階段進行調整。若在時序分析階段發現時序問題,就需要回到合成階段或布線與繞線階段,進行必要的調整。在實體驗證階段,若發現違反設計規則、布局和電路圖不符,就需要回到布線與繞線階段。
此外,EDA也包括功能驗證(Functional Verification)。狹義的功能驗證在RTL設計與模擬階段執行,是為了檢驗VHDL或Verilog程式碼的邏輯,並符合規格需求。廣義的功能驗證則擴展至其他階段,例如在規格和設計描述階段,能對設計規格進行初步的驗證;在合成階段,能確保合成的網表具有規格所需的功能;在DFT階段,能檢驗出測試用的特殊結構是否會改變原電路的設計功能;在時序分析和最佳化階段,能檢查時序限制(Timing Constraint)是否會造成電路功能錯誤;在實體驗證階段,能確保更改實體設計不會產生電路功能的錯誤。EDA的功能驗證是連續的作業流程,幾乎存在於EDA開發流程中的每一個設計階段,以確保整體開發流程的設計正確性。
矽晶圓廠的晶片製造流程大致可分為:半導體元件製造(Device Fabrication)、晶圓測試(Wafer Test)、封裝(Packaging)、半導體元件測試(Device Test)。這裡所謂的半導體元件包含廣泛,小至電子零組件,例如二極體、一般用途的雙極性電晶體(BJT)、電源管理用的MOSFET或IGBT電晶體等,大至如CPU、SoC等微處理器(Microprocessor),還包含DRAM、SDRAM、FLASH等記憶體、ADC或DAC類比裝置、射頻放大器、射頻開關、感測器、ASIC、FPGA等。圖2為VLSI從EDA開發到交付矽晶圓廠製造的流程。
ASIC開發流程
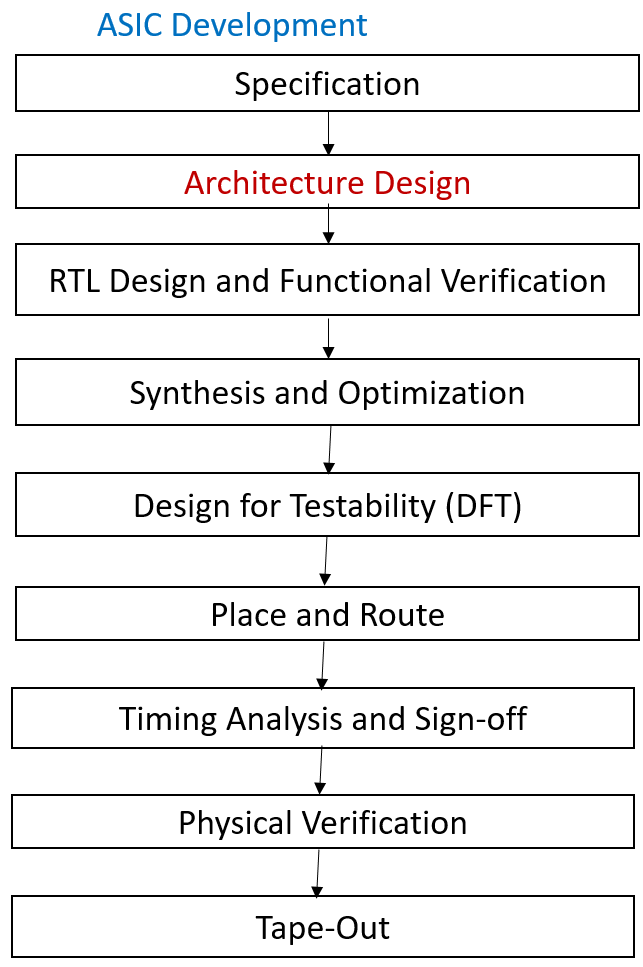
ASIC的開發流程也包含上述的八個循環設計階段,此外,在規格定義階段和RTL設計和功能驗證階段之間,增加了架構設計(Architecture Design)階段,如圖3所示。
以下列出ASIC開發流程和EDA開發流程最大的不同:
・規格定義和市場分析:開發ASIC之前,需要定義更詳細的技術規格並完成市場分析,以確保設計出來的ASIC能夠符合未來趨勢和客戶需求。
・架構設計:此為開發ASIC的關鍵階段。架構設計和功能區塊的劃分,攸關ASIC的性能和成本。
・功能驗證:由於ASIC針對特定應用而設計,且此類應用通常十分複雜、特殊,因此開發ASIC需要更廣泛的功能驗證。
・最佳化:ASIC開發流程特別注重功率、性能和面積(Power, Performance,and Area, PPA)的最佳化。
・簽核檢查(Sign-off Check):ASIC開發包含了嚴謹的簽核檢查作業,以確保所設計的電路可製造且符合所有規格需求。
以ASIC開發DLA
RISC-V是精簡指令集電腦(Reduced Instruction Set Computer, RISC)的縮寫,相對於開源軟體,它是一種開源硬體。目前看來,使用RISC-V核心的開放原始碼和ASIC來開發DLA,似乎是未來的趨勢。
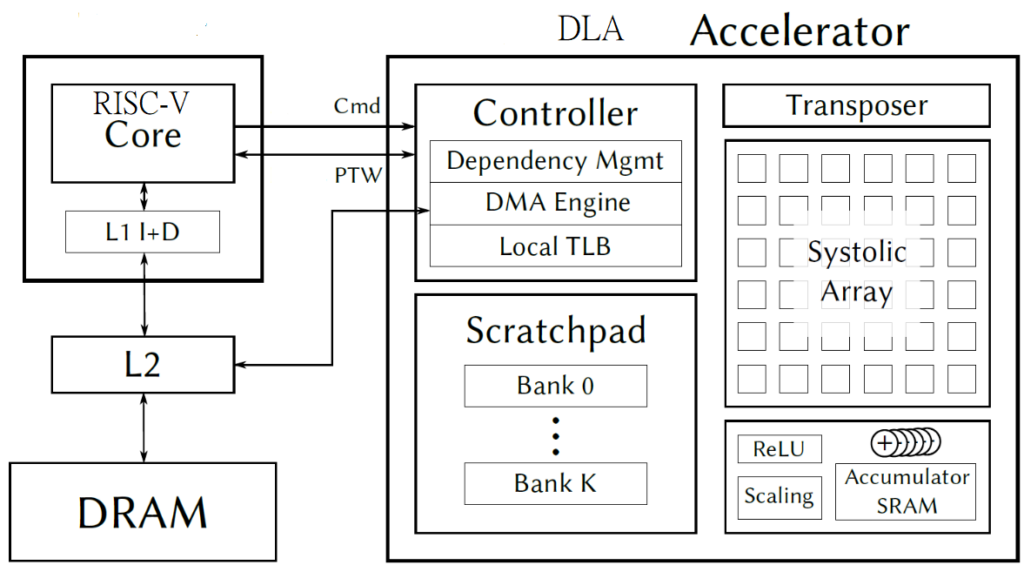
圖4為採用脈動陣列(Systolic Array)的DLA內部架構。在這個虛擬的DLA內部雖然包含控制器(Controller),但此控制器是連接至外部的RISC-V核心,接受RISC-V指令的控制。圖4中也包含了分頁表查找(Page Table Walk, PTW)訊號,當DLA擷取記憶體時,可能需要將虛擬位址轉換成實體位址,這需要透過分頁表來完成,因此,當PTW訊號產生時,代表DLA正在進行位址轉換。
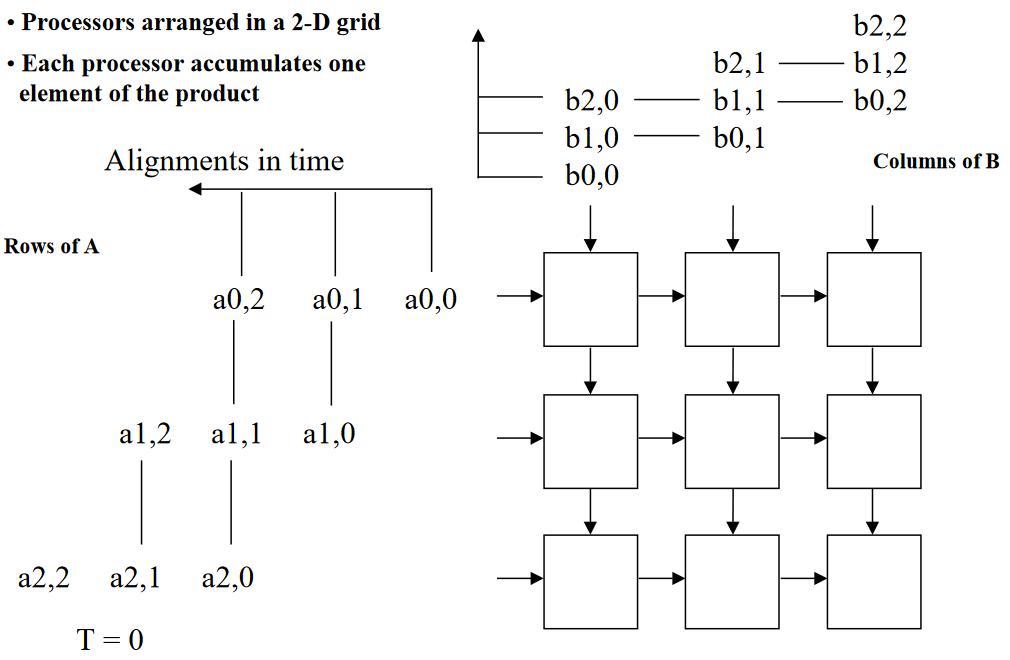
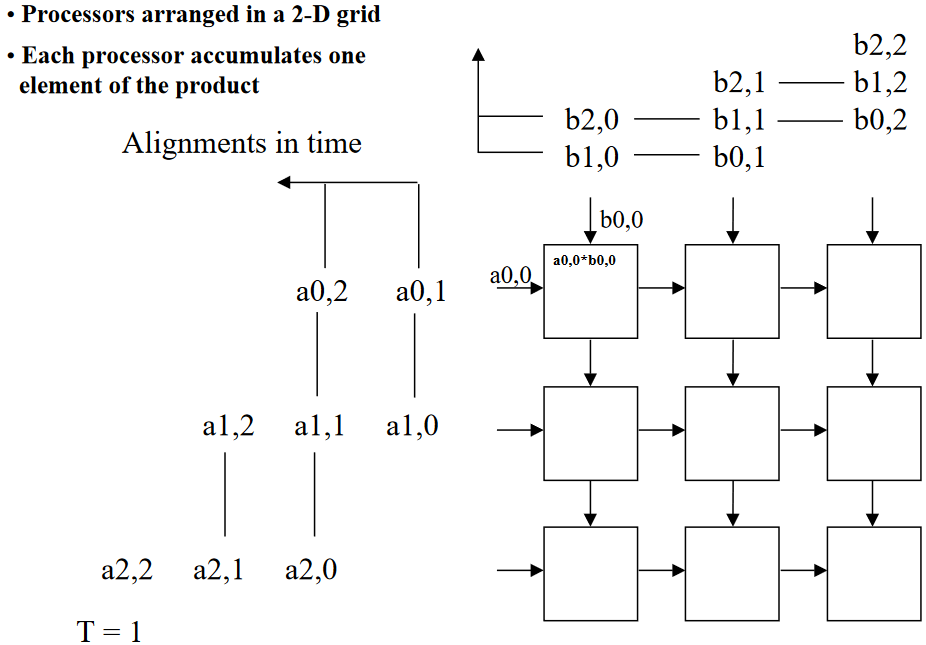
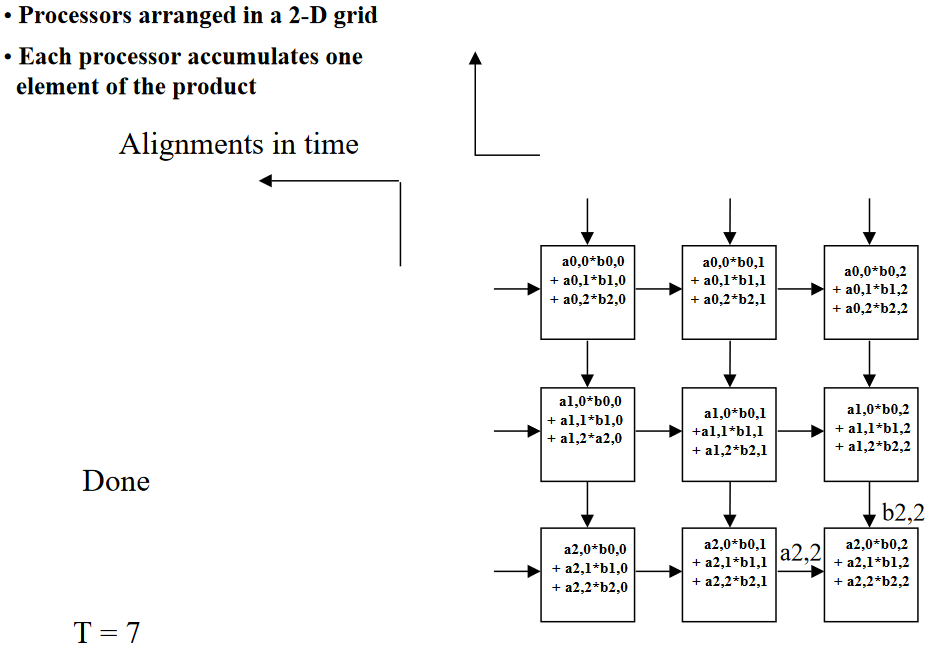
圖5是脈動陣列的工作範例,其可執行兩個3*3矩陣的相乘。從使用者介面輸入的矩陣相乘程式被轉換成RISC-V指令,並傳送至脈動陣列,它能立刻完成計算。每個處理單元(Processing Element, PE)內部具有緩衝器,可以儲存前幾次運算的結果。例如,3*3矩陣的a、b相乘等於矩陣c,在T=7時,最後一個PE的前兩次計算累加的值是a2,0*b0,2+a2,1*b1,2,加上這次計算的值a2,2*b2,2,這個PE最後運算的結果就等於a2,0*b0,2+a2,1*b1,2+a2,2*b2,2,這正是c2,2的值。
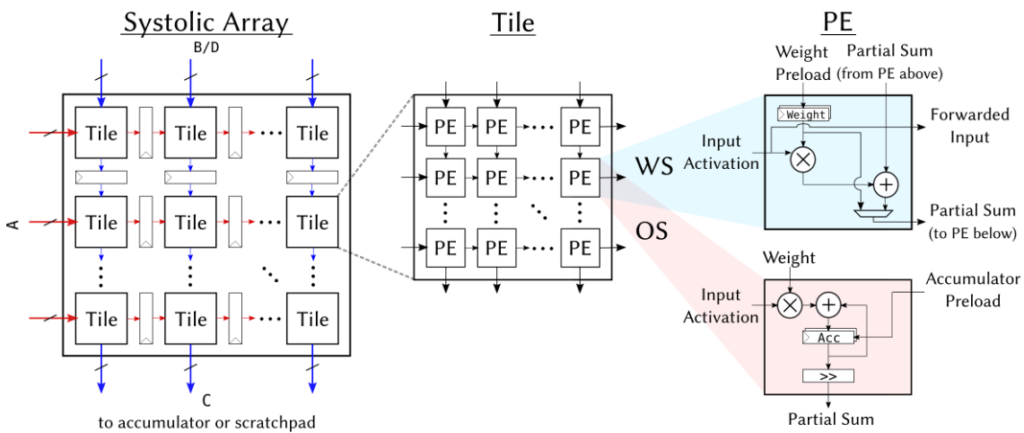
脈動陣列具有平行運算的特性,適合DLA應用。圖5所舉的脈動陣列範例是簡單的構造,複雜的脈動陣列可由許多拼塊(Tile)構成。拼塊由許多PE構成,如圖6所示。由於此DLA是和RISC-V核心結合,脈動陣列的大小和複雜度可以按照規格需求進行調整。
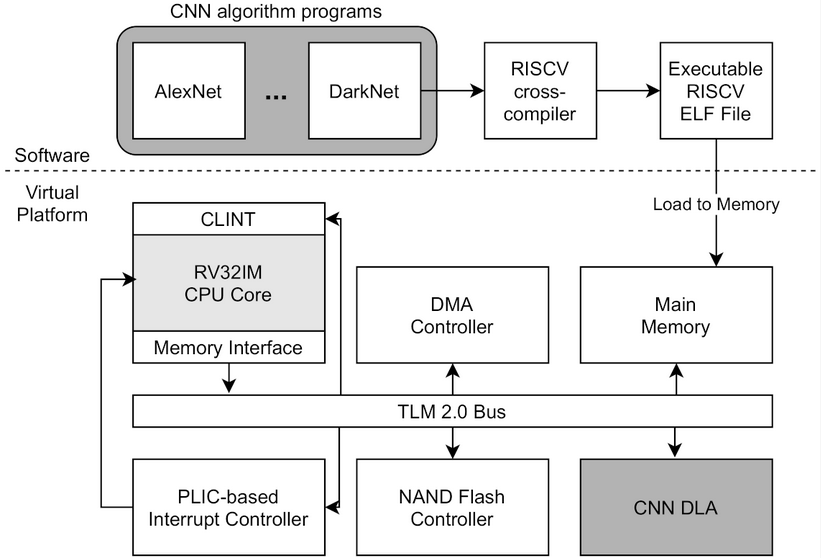
圖7顯示以另一種RISC-V虛擬平台開發或模擬DLA,其同樣為虛擬DLA,可允許設計人員在投入昂貴且耗時的實體ASIC製造流程之前,先對DLA的架構和功能進行建模、模擬和驗證。設計人員還能在這個平台上面,開發驅動程式和應用軟體,檢驗軟硬體的相容性和系統效能。
不過,上述的兩個RISC-V虛擬平台都只能產出虛擬的DLA,皆是過渡產品,通常在模擬環境完成驗證後,會先使用FPGA實現DLA,進一步驗證和微調,最後仍須按照圖2和圖3所列出的開發流程,直到完成量產、封裝、測試和布建。
著人工智慧技術從雲端向裝置端遷移,Edge AI(邊緣人工智慧)正以驚人速度重塑產業面貌。在台灣Edge AI技術開發與應用交流大會上,來自科技巨頭、研究機構與新創公司的五位專家,從不同角度勾勒出一個共同願景:輕量化模型將成為實現邊緣智慧的關鍵推手。
大會邀請的五位講者雖從不同視角切入,卻呈現出鮮明的共通論點:「小而精」的模型比龐大的雲端模型更適合邊緣運算環境。無論是微軟提出的混合式AI架構、滿拓科技的晶片最佳化技術、資策會的企業導入策略、台達電子的記憶體內運算,還是IBM強調的輕量化模型,均指向同一方向:在有限的算力和能源約束下,打造高效能的邊緣智慧解決方案。
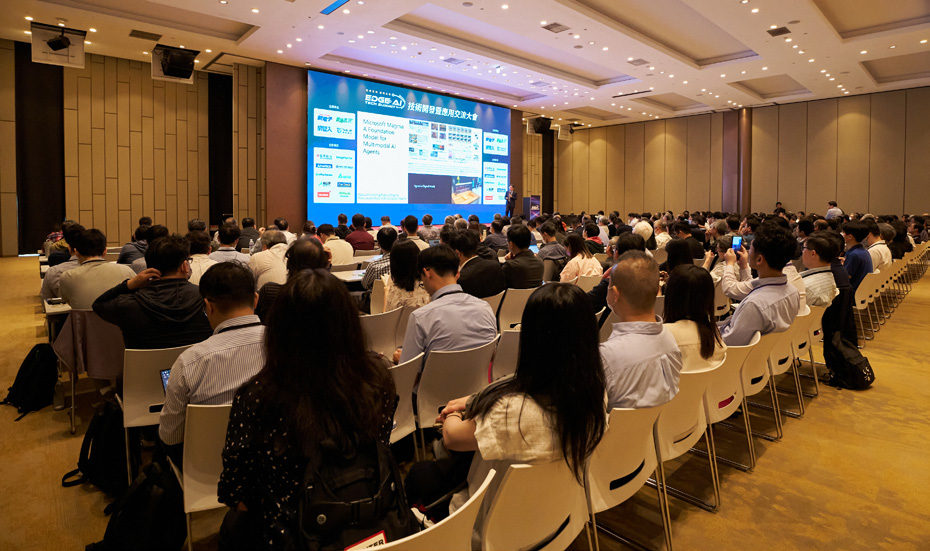
邊緣AI之所以重要,不僅在於它能解決雲端AI的網路延遲、隱私保護與能源效率三大問題,更在於它與台灣既有產業優勢的完美契合。台灣在半導體、硬體製造領域擁有世界級實力,而輕量化的邊緣AI正需要專用晶片、最佳化演算法與精密硬體的支持。這種產業互補性,賦予台灣在全球Edge AI競爭中獨特的戰略地位。
本次大會五場專題演講,從混合AI架構、AI模型與晶片開發、企業導入策略、記憶體內運算,以及輕量化模型等面向,全面展現了台灣在Edge AI領域的創新成果與未來發展路徑。這些技術路徑不僅代表了當前產業趨勢,更為台灣科技產業在下一代人工智慧時代指明了前進方向。
從邊緣AI到混合AI的技術大趨勢
台灣微軟首席技術長花凱龍在演講中分享了從邊緣AI到混合AI的發展趨勢。花凱龍同時也是臺灣科技大學資訊工程系教授,具備豐富的學術與產業經驗。
在探討混合AI架構時,花凱龍強調微軟本身在雲端應用方面擁有較多元的場域,而近期在多重代理人的帶領下,從雲端到地端的所有解決方案,整個混合式AI已成為業界關注的焦點。他從麥肯錫的趨勢報告切入,闡述生成式AI對各產業的深遠影響。辦公室文化正因AI工具而改變,微軟推出了多種Copilot工具,連法務專業人員也開始使用本地方式生成代理人來協助日常工作,展現AI在各領域的實際應用價值。
演講中特別著墨於少子化問題與AI的解決方案。花凱龍指出,在勞動力持續減少的前提下,如何透過更自動化的方式或透過AI賦能來應對這些挑戰,已成為各界高度關注的議題。他深入剖析了ChatGPT的發展歷程,以及Microsoft Copilot PC的最新應用特色,包括Recall功能、Co-Creator以及Studio Effects等。
邊緣AI部署的挑戰與解決之道
滿拓科技執行長吳昕益在大會上分享了邊緣AI部署的現實挑戰與解決方案。吳昕益擁有清華大學資工博士和台灣大學電機碩士學位,在嵌入式系統設計和晶片設計領域擁有豐富經驗,曾完成台灣第一顆硬體NAT加速晶片。
回顧滿拓科技的技術發展歷程,吳昕益提到公司自2018年成立以來一直專注於邊緣運算的部署,從小型電腦視覺落地到小型大語言模型開發的每一步技術演進。他深入分析了邊緣AI部署面臨的四大挑戰:大型模型難以落地、算力限制、計算與記憶體雙重瓶頸,以及軟硬體之間的斷層。針對這些挑戰,滿拓科技開發的專利技術能將運算量和資料量減少90%,同時保持高精準度。
公司核心產品包括DeepLogCore晶片開發方案和DMAI Series系統設計平台,以及全球獨家的「高效自動化AI晶片設計流程」專利技術。在市場應用方面,電信和政府部門走得較快,接下來是金融服務和製造業。滿拓科技的價值在於能夠將整個產業串連起來,從應用到技術形成完整生態系統。
生成式AI的企業導入與評測策略
資策會軟體技術研究院院長蒙以亨分享了「裝置端人工智慧運算與評測」的見解。資策會近年在人工智慧技術研發上投入重大資源,專注於生成式人工智慧的企業導入和人工智慧評測服務兩大核心議題。
談及資策會的工作理念,蒙以亨強調幫助需求端快速建立生成式人工智慧應用,同時引入供給端的解決方案,讓各方能從零到一,再從一快速複製到多的重要性。在演講中,他特別著重資策會扮演橋樑角色,促進整個產業生態系統的發展,而非與民爭利的定位。蒙以亨指出,無論何種人工智慧應用,都需要評估其可信度、安全性及合規性。
企業導入人工智慧面臨多種痛點:效益難以計算、資源分配問題、算力需求估算困難等。資策會能協助廠商以最經濟的成本規劃適合的資源配置。根據調查,台灣已有54.2%企業導入生成式人工智慧,比前年大幅成長。資策會開發的生成式AI應用快製平台,能協助企業完成從評估、測試到營運的全程導入,提供完整解決方案。
記憶體內運算:邊緣AI的能源效率革命
台達電子技術長暨台灣大學資訊工程學系特聘教授郭大維,分享了記憶體內運算作為邊緣人工智慧新架構的前瞻觀點。
郭大維回顧了AI領域近三年重大發展,從ChatGPT到ChatGPT-4,再到Sora等影像生成技術和LLAMA 3.2等輕量化模型,這些技術進展預示了邊緣AI的巨大潛力。邊緣人工智慧市場預計到2031年市值將超過1400億美元,消費電子、製造業、汽車工業和醫療保健等台灣擅長的產業正快速成長。
邊緣AI興起源於兩個關鍵因素:5G、6G時代產生的巨量數據無法全部傳至雲端,以及多種應用對即時性的嚴格要求。然而,發展邊緣AI的根本挑戰在於能源消耗。郭大維剖析了馮紐曼架構的局限:這種沿用90多年的架構需在記憶體和處理器間不斷移動資料,造成「記憶體牆」問題,導致能源效率低下。現今僅需兩個750兆瓦的AI數據中心就要一座核電廠供電,而邊緣裝置更無法承載耗電的大型處理器。
針對此挑戰,業界提出「記憶體內運算」的新設計架構。郭大維指出,這種架構將資料處理直接在記憶體內完成,將神經網路映射到記憶體晶片上,每個記憶體單元同時作為計算單元,消除資料搬移需求,大幅降低能耗並實現平行運算,能效比可較傳統處理器提升數十倍。
記憶體內運算適合多種應用:感測器數據可直接在記憶體中處理;安全系統可即時處理識別信號;工業環境可監測危險區域。相較於嵌入式系統,記憶體內運算可能僅是專用晶片加少量輔助硬體,代表邊緣運算的「最前緣」,專為特定任務優化。
展望未來,記憶體內運算將改變傳統資料處理方式,在產生地直接處理資料,提高即時性和隱私保護,為下一代AI應用提供高效節能的解決方案,對能源受限的邊緣場景具革命性意義。
實現邊緣AI的關鍵考量
IBM AI技術顧問許瑞萍分享了從企業導入第一線的實務經驗。許瑞萍以實戰角度剖析企業客戶在AI導入過程中面臨的挑戰與輕量化模型的優勢。
從企業實際需求出發,許瑞萍指出相較於需要2-4張A100或H100 GPU的70億參數模型,有些輕量化模型甚至不需要GPU就能執行,大幅降低企業導入AI的門檻。根據IBM從2022年至2025年的觀察,企業對AI的態度已從評估、認識階段發展到開始進行概念驗證,探索具體應用場景。
企業導入AI面臨的主要挑戰包括資料品質問題和人才短缺。根據麥肯錫報告,真正成熟落地AI的企業僅佔1%。大多數企業仍處於概念驗證或單點試驗階段,擴展時常遇到系統整合和資料問題。
在Edge AI領域,輕量化模型能部署在終端設備上,降低延遲、提高隱私保護,且更專注於特定任務。這種「小而精」的模型正好符合企業對特定場景的需求。IBM透過知識蒸餾等技術最佳化模型,協助企業建立更貼近其需求的AI系統。
許瑞萍特別強調AI治理的重要性,指出企業常先詢問使用什麼模型,而不是先確定使用情境,這是本末倒置的做法。她建議企業應先建立完整的AI治理框架,從上到下組建AI治理委員會,明確運用範圍、責任分工和可用資料。IBM從評估、建置到維護的全程服務,能協助企業從小型驗證逐步擴展到全面應用,兼顧Edge AI和雲端發展。
台灣在邊緣AI產業鏈的關鍵定位
台灣Edge AI技術開發與應用交流大會的五場專題演講,從不同角度揭示了邊緣AI的發展現況與未來趨勢。從微軟的混合AI架構、滿拓科技的模型晶片最佳化技術、資策會的企業導入策略、台達電子的記憶體內運算革新,到IBM的邊緣AI應用實務經驗,共同勾勒出台灣在全球邊緣AI產業鏈中的關鍵定位。
隨著AI技術從雲端延伸至邊緣裝置,台灣憑藉在半導體、硬體製造的優勢,有機會在這波技術浪潮中扮演舉足輕重的角色。從晶片設計、演算法最佳化、系統整合到應用開發,台灣擁有完整的產業鏈優勢。特別是在低功耗、高效能的Edge AI晶片開發方面,台灣廠商已展現獨特的技術實力。
未來,隨著算力提升、能源效率改善和商業模式成熟,邊緣AI將從實驗室走向市場,成為台灣科技產業新的成長引擎。透過產官學研合作,建立從晶片到應用的完整生態系,台灣有望在全球邊緣AI市場中佔據一席之地,為產業升級和經濟發展注入新動能。