
語音即介面」——這是語音社群在「2025年所傳遞的核心主張,至今
仍具有重要意義。語言是人類最早掌握
的溝通技能之一,也是我們生活中最自
然的互動方式。然而,要真正理解以語
音對話,遠不止於將語音轉錄為文字那
麼簡單。恩智浦認為,機器人若要與人
類自然溝通,就必須具備人類所熟悉的
各種社交能力。
人類可以同時處理多種資訊。他們
會解讀視覺線索,例如情緒表現、手勢
與視線方向;能夠判斷說話暫停是在思
考,還是已經結束發言;能理解多人對
話情境,並掌握發言順序;能過濾雜
訊、回聲與混響;還能根據互動情境,
例如場合、對方年齡與外貌,調整回應
因此,恩智浦將這些人類自然具備的社交能力,視為機器人語音互動設計的重要基礎。
數十年來,AI領域已開發了多項基礎語音技術,如關鍵字喚醒、語音轉文本(Speech-to-Text, STT)和文本轉語音(Text-to-Speech, TTS)。大語言模型(Large Language Model, LLM)與視覺語言模型(Vision-Language Model,VLM)則進一步賦予智慧系統更強大的推理能力。近期,音訊語言模型與語音到語音模型等技術也試圖縮小語音處理與推理能力之間的落差。然而,迄今為止,這些方法仍無法在邊緣端為機器人提供可靠且低延遲的對話式AI解決方案。
當對話系統在真實環境中失效時,常見的應對方式,是擴大模型規模或採用更複雜的提示詞加以補償。然而,這只會增加推理延遲,進而影響使用者體驗,同時未能觸及根本問題:輸入音訊的品質不佳。
多模態感知提升語音理解
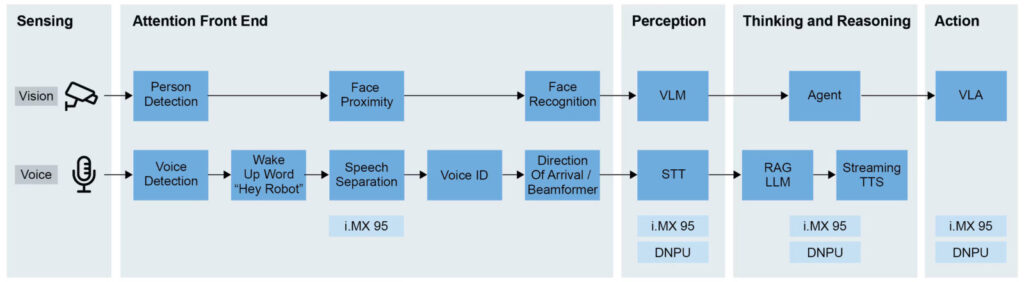
隨恩智浦的注意力前端(Attention Front End, AFE)解決方案透過融合多模態感知與音訊訊號處理,直擊人機互動的核心挑戰(圖1)。該系統並非處理所有傳入音訊,而是精準偵測使用者何時希望與機器人互動,並強化傳入音訊,進而提供可靠且低延遲的裝置端對話體驗。這也帶來了額外的好處:如此一來,系統便不必完全依賴龐大的雲端模型。
我們的解決方案充分利用以下互補模態:
・視覺:分析場景,偵測並計算人員數量,識別已註冊使用者,估算距離,並判斷正在面向機器人說話的使用者
・語音:檢測語音活動,辨識已註冊的聲音特徵、估算聲音來源方向,並將收音方向聚焦於目標說話者,同時分析背景中的聲學場景特徵。
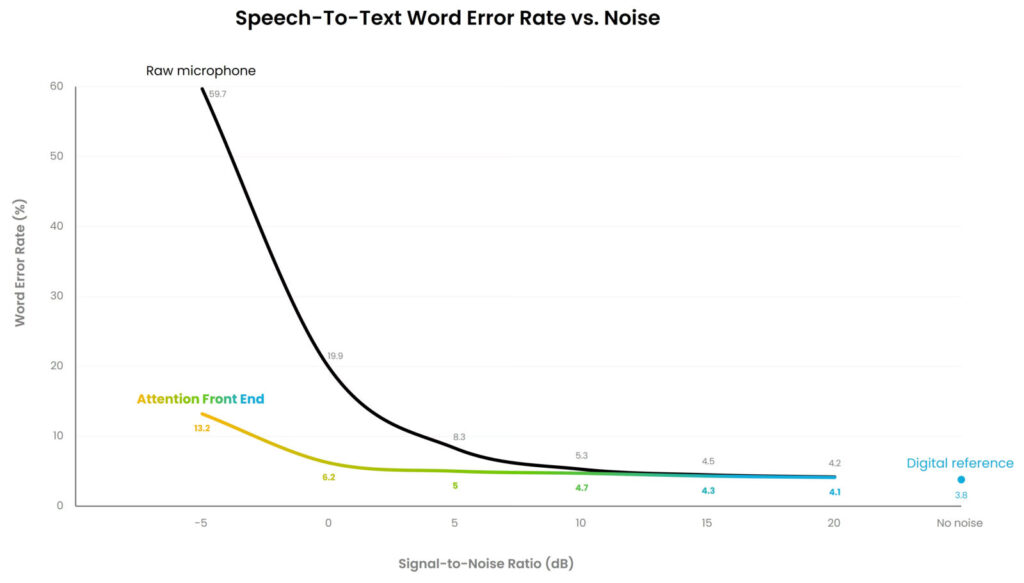
語音轉文字處理僅在多項條件同時滿足時才會啟動:系統同時透過視覺與聲學資訊辨識使用者、偵測到語音活動,且互動距離與方向均符合條件。透過多模態資訊先判斷是否存在有效的人機互動,再將經過強化的音訊送入STT模型,可避免模型持續處理無關或品質不佳的音訊資料。這套閘控機制結合恩智浦自主研發的語音與音訊演算法,可在從安靜環境到嘈雜場景(如低訊噪比條件)的廣泛環境下,顯著改善詞錯誤率(WER)。
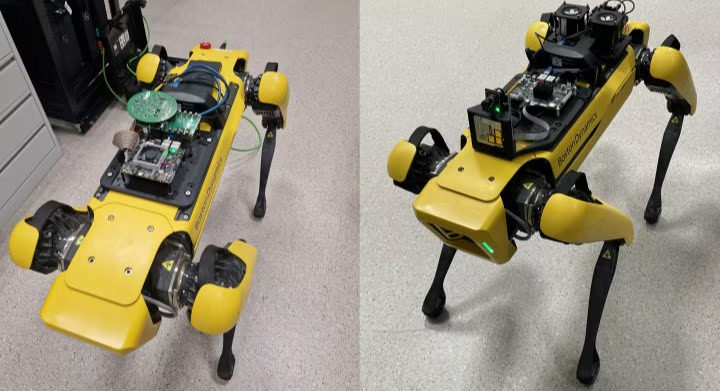
恩智浦還整合了超寬頻(Ultra-Wideband, UWB)技術,將空間感知能力拓展至語音與視覺之外。透過Trimension SR250等解決方案,機器人能安全掌握使用者智慧手機或其他機器人的即時位置,進而了解使用者或同伴的方位並做出適當回應。UWB可提供公分級高精度測距,同時兼具低功耗與複雜環境下的穩定性。這類精確且可靠的位置資訊,可進一步強化室內外場景中的導航、互動,以及依據距離觸發的行為(圖2)。
從模組化設計看效能提升
圖3展示注意力前端搭配語音轉文字模型(如Whisper)後,WER相較於僅使用模型時的改善情況。
簡言之,注意力前端讓機器人更接近人類的聽覺處理方式:聚焦於正確的說話者並忽略干擾,即使在嘈雜環境中也能理解對話。通透過融合視覺、語音與距離感知,注意力前端能為語音辨識模型提供更純淨的音訊輸入,進而提升回應速度與辨識精度,同時讓對話式AI在邊緣端實現更自然的互動。