
AI模型的訓練跟推理,不只依賴GPU提供的運算能力,同時也需要高效互聯作為背後支撐的骨幹。
為實現基於開放標準的AI機架與叢集,
多家業界大廠將希望寄於UEC與UALink兩項技術。
分散式運算成必然選擇
管是大模型的訓練,或提供基於大模
開放/封閉網路技術對決
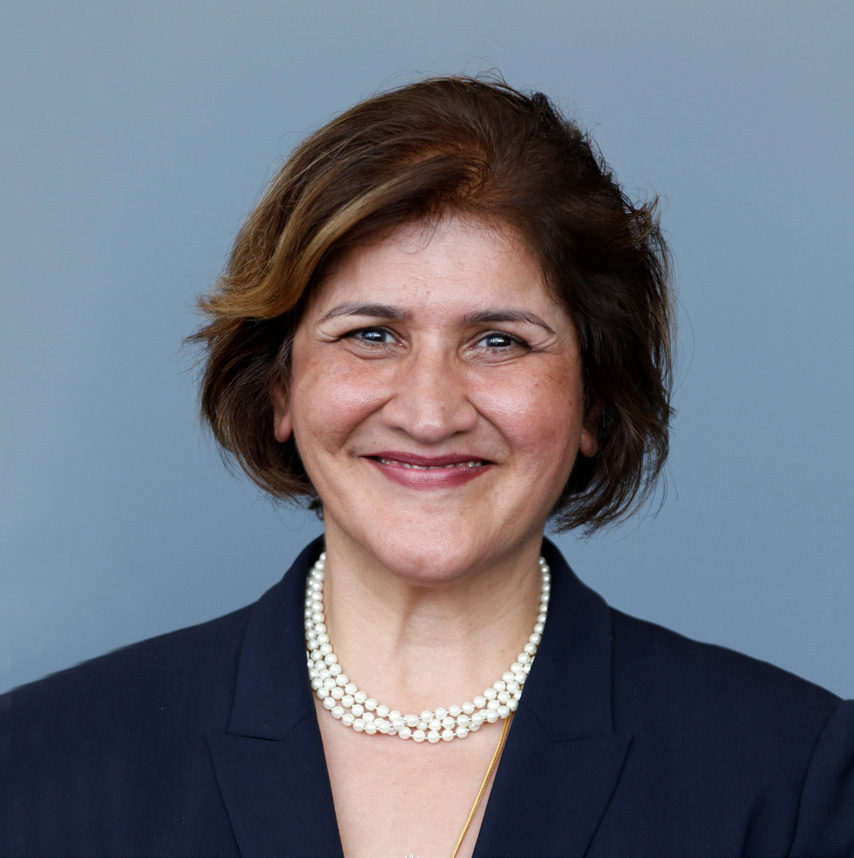
型的推論服務,都需要透過高速介面串接大量GPU加速器,才有可能實現。超微資深副總裁暨網路技術與解決方案因此,在生成式AI的生態系中,除了搶盡事業群總經理Soni Jiandani(圖1)指出,由於鎂光燈的GPU之外,高速介面技術更是不AI模型的參數量與訓練模型的資料集,其可或缺的骨幹。根據花旗銀行的估算,到規模成長速度都遠超過電晶體數量增加的速2028年時,AI運算相關市場的規模可達度,因此,我們無可避免地一定要用分散式系統架構來訓練AI模型或部署AI應用服5630億美元;網路相關設備的市場規模,
則達到1190億美元。由此便可看出,將一務。這使得網路技術的可擴展性變得十分關台台AI伺服器串接成運算叢集(Cluster)的高鍵。速介面技術,在AI發展中扮演的角色。
目前,業界用來建構AI運算叢集的網路
但也因為高速介面是AI生態系的樞紐,
技術可以分成兩大陣營,一是Infiniband,如何在高速介面領域打破NVIDIA一家獨大另一個則是乙太網。Infiniband的可擴展性的局面,進而為自家的GPU加速器或ASIC有限,乙太網則具有優秀的可擴展性,但現創造出更多空間,成為想在AI資料中心市有的乙太網技術並不是為了AI運算的需求所打造。因此,如果要建構大型AI資料中場有所作為的晶片供應商,都必須面對的課題。超微(AMD)在2022年斥資19億美元心,在乙太網技術的基礎上進行擴充跟改良,使其符合AI運算的應用場景需求,會買下Pensando,就是為了補強自身在資料中心網通領域的產品組合,而做出的策略性是最理想的選擇。這就是UEC(Ultra Ethernet Consortium)聯布局。
盟之所以成立的原因。在一個大型AI資料中心裡,客戶可能會需要連接成千上萬,甚至更多顆GPU。這時,負責在機櫃間實現水平擴展(Scale-out)的後端網路,一定要具備極佳的可擴展性。從乙太網技術演化而來的UEC技術,其可擴展性是Infiniband的20倍、傳統乙太網的10倍。這使得UEC成為比現有技術更優秀的選項。
她強調,給客戶更多選擇,是超微一貫的主張。以2024年10月發表的Pollara AI NIC方案為例,該網卡不只具有更好的可擴展性與優於競爭同業的性能表現,更重要的是客戶可利用Pollara引擎的可編程特性,選擇自己想要的協定,不論是基於產業標準的UEC,或是客戶自己客製化的協定,Pollara都可以支援。
Jiandani透露,目前大型雲端服務業者(CSP)使用客製化傳輸技術的情況,其實相當普遍,只是程度有別。因此,網路技術必須具有可編程性,才能滿足客戶需求。而且,因為Pollara是可編程的,客戶可以很輕鬆地升級自家資料中心裡的Pollara,使其支援最新的技術。這些特性使得Pollara AI NIC能大幅降低客戶的總體持有成本(TCO),使其成為更具性價比的選擇。
事實上,超微在開發Pollara時,就一直將高性能、高可擴展性與低TCO列為主要的設計目標。要做到這點,除了硬體面的創新,軟體創新也非常關鍵。超微的UEC軟體有三個主要的差異化,分別是路徑感知壅塞控制(Path-aware Congestion Control)、選擇性重傳(Selective Retransmission)與高效率負載平衡(Load-balancing)。藉由這三項軟體技術加持,Pollara AI NIC在執行UEC傳輸時,效能表現可以比現有的RoCEv2傳輸提升25%,並盡可能避免GPU閒置或網路故障。
運算叢集的上線時間與利用率,其實是影響資料中心TCO的一個重要關鍵。根據Meta分享的資料,在該公司進行Llama 3 405B模型預訓練的54天中,約有10%的故障可歸咎於網路因素。這會對AI資料中心的TCO帶來很大的衝擊。因此,對AI資料中心的擁有者而言,用來建構運算叢集的網路技術不只要足夠的頻寬、更低的延遲,以及更容易擴展的特性,強固性(Robustness)也很關鍵。結合超微的UEC軟體,GPU的上線時間可以增加大約10%。
UALink與機櫃方案Helios明年登場
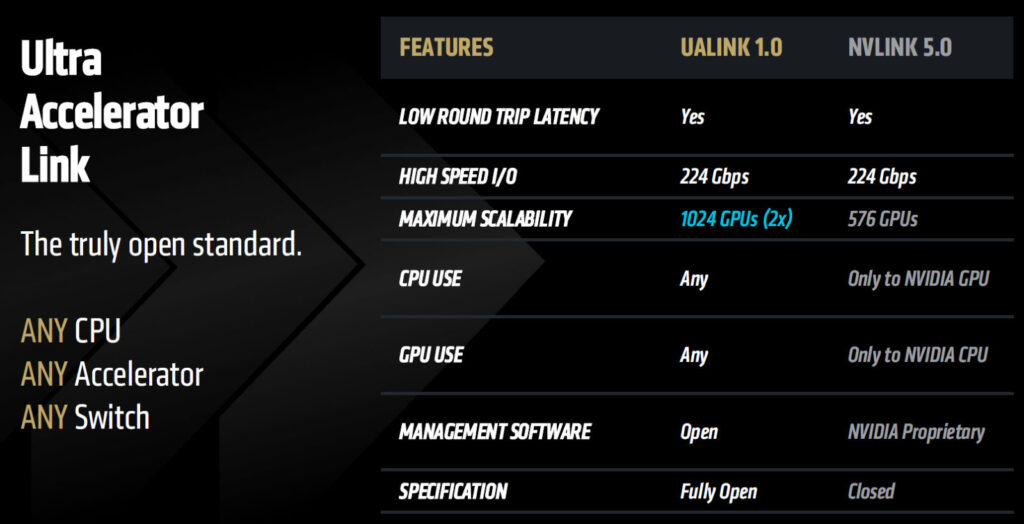
至於在機櫃內連接多顆實體GPU,使其成為一顆巨型虛擬GPU的垂直擴展(Scale-up)技術方面,可擴展性一樣非常重要,而且這種技術需要比水平擴展網路技術更高的頻寬、更低的延遲。與NVIDIA的NVLink相比,UALink(Ultra Accelerator Link)可以連接的GPU數量是其兩倍,而且可以連接任何供應商的CPU、GPU或交換機,管理軟體也是開放的,可以讓客戶擁有選擇供應商的權力(圖2)。
根據超微的產品規劃,預計在2026年推出,產品代號為Vulcano的下一代產品,將會支援UALink與PCIe 6。如果是在UALink模式下,其頻寬將會是PCIe 6的兩倍。在水平擴展部分,Vulcano的網路吞吐量將升級到800G,並且可以提供給每顆GPU 8倍於現有方案的水平拓展頻寬。超微將在2026年推出Helios AI機櫃,裡面除了將搭載超微的下一代CPU、GPU,也會採用Vulcano作為其水平與垂直擴展方案。
開放AI生態系的旅程才剛開始
Jiandani總結說,網路技術是建構AI運算叢集的基礎。如果沒有強大、開放的網路解決方案,要建構出一個大型的AI運算叢集,是不可能達成的。今天,Pollara NIC已可為客戶帶來縮短15%運算任務執行時間、叢集可用性提升10%,以及成本降低16%的效益。將於2026年正式推出的Helios機櫃解決方案,將把這一切提升到一個新的境界,讓AI運算更具擴展性、更可靠,加速AI的創新。而開放的生態系,包含UEC、UALink,則是Helios的基礎。這段基於開放生態的AI旅程,才剛剛開始。